1、目标#
==LR 实现线性预测== 任务: 基于
generated_data.csv数据,建立线性回归模型,预测x=3.5对应的y的值,评估模型表现。
2、generated_data.csv数据#
x,y
1,7
2,9
3,11
4,13
5,15
6,17
7,19
8,21
9,23
10,253、加载数据#
# load the data
import pandas as pd
data = pd.read_csv('generated_data.csv')

# 打印类型和维度
print(type(data), data.shape)
print(data.head())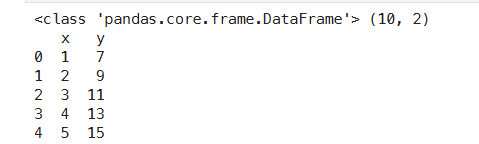
4、data赋值#
# data 赋值
x = data.loc[:, 'x']
y = data.loc[:, 'y']
print(x, y)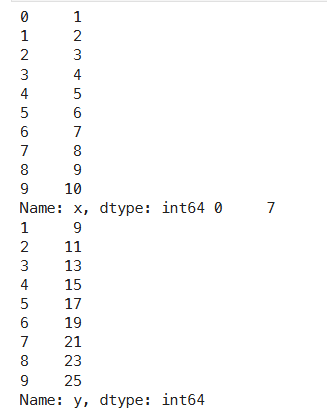
5、画出可视化图表#
# visualize the data

from matplotlib import pyplot as plt
plt.figure(figsize=(5, 5)) # figsize 设置图表的大小
plt.scatter(x, y)
plt.show()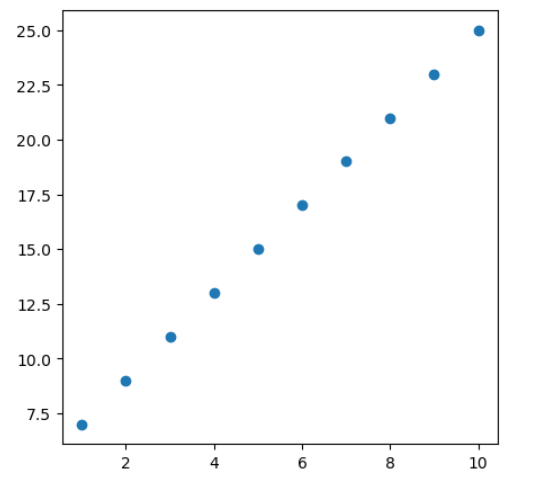
6、建立线性模型#
6.1、先安装sklearn库#
pip install scikit-learn -i https://pypi.tuna.tsinghua.edu.cn/simple6.2、构建模型开始训练#
# set up a linear regression model
from sklearn.linear_model import LinearRegression
# 构造线性模型
lr_model = LinearRegression()
训练模型:
# 训练模型
lr_model.fit(x, y)
报错了:
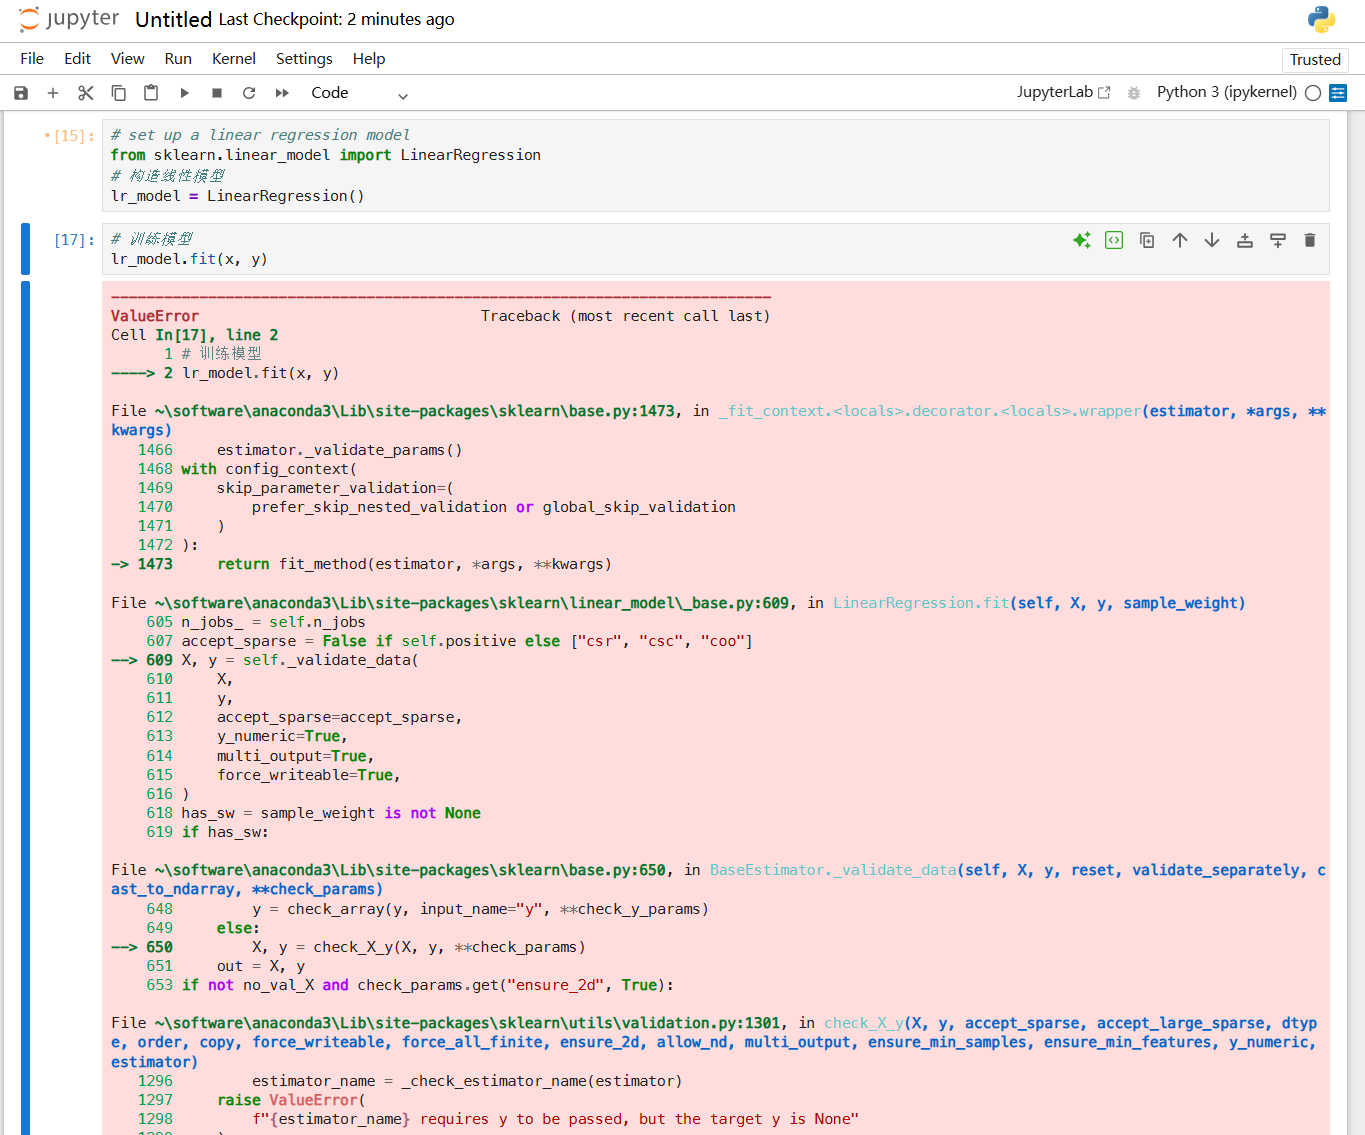
报错原因是:训练维度不对,
fit训练方法需要的是数组对象。需要先将 dataframe 转化为 数组。
6.3、转换类型#
import numpy as np
x = np.array(x) # 将 dtype 的 x 使用 np 转化为 array 数组
x = x.reshape(-1, 1) # reshape 第一个参数-1表示动态生成多行,第二个参数1表示一列
print(type(x), x.shape)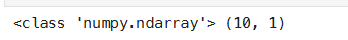
可以看到输出已经变成一个 10行1列的 ndarray 了。
# 同样处理 y
y = np.array(y)
y = y.reshape(-1, 1)
print(type(y), y.shape)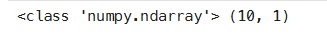
6.4、重新训练#
lr_model.fit(x, y)
6.5、预测目标值#
# 预测 x=3.5 对应的 y 的值
y_predict = lr_model.predict([[3.5]]) # 注意:这里也需要对3.5进行维度的转化为二维才可以调用
print(y_predict)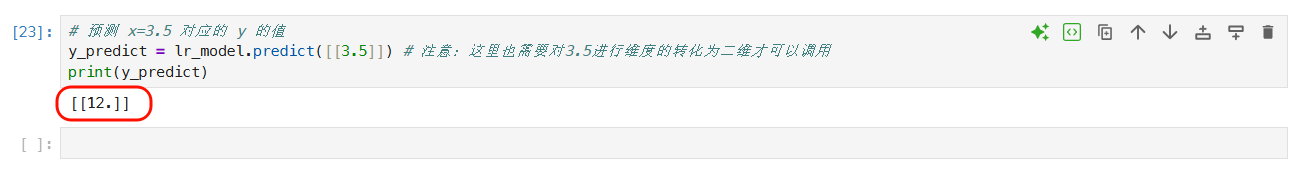
6.6、打印f(x)函数关系#
# 打印f(x)
a = lr_model.coef_
b = lr_model.intercept_
print(a, b)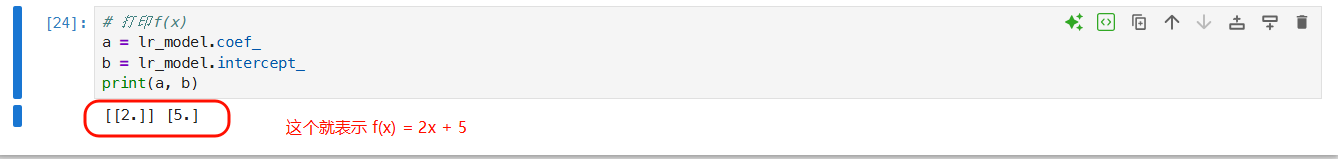
6.7、计算拟合均方误差#
# 查看给出的 y 值 与 预测出来的 y 值的均方误差,该误差值越小越好
# 先获取根据该模型所有预测出来的y的值
y_precdict_all = lr_model.predict(x)
# 原始 y 值,没有处理,就是 y
from sklearn.metrics import mean_squared_error, r2_score
MSE = mean_squared_error(y, y_precdict_all)
R2 = r2_score(y, y_precdict_all)
print(MSE, R2)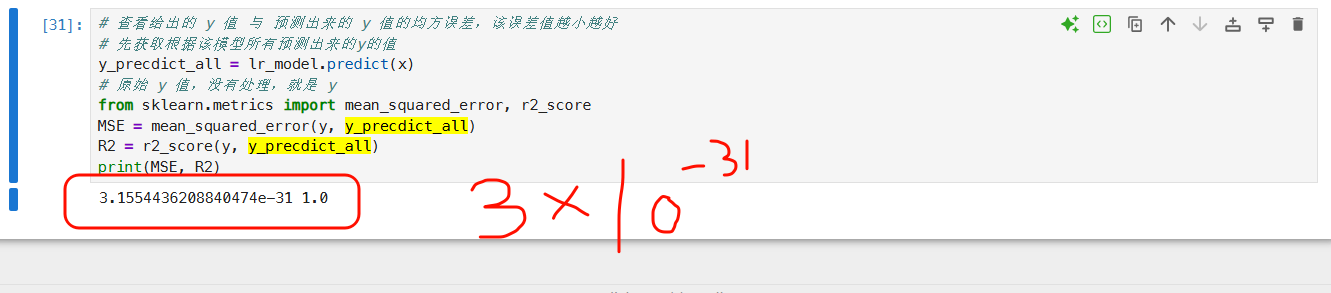
6.8、画出y与预测的y的关系图#
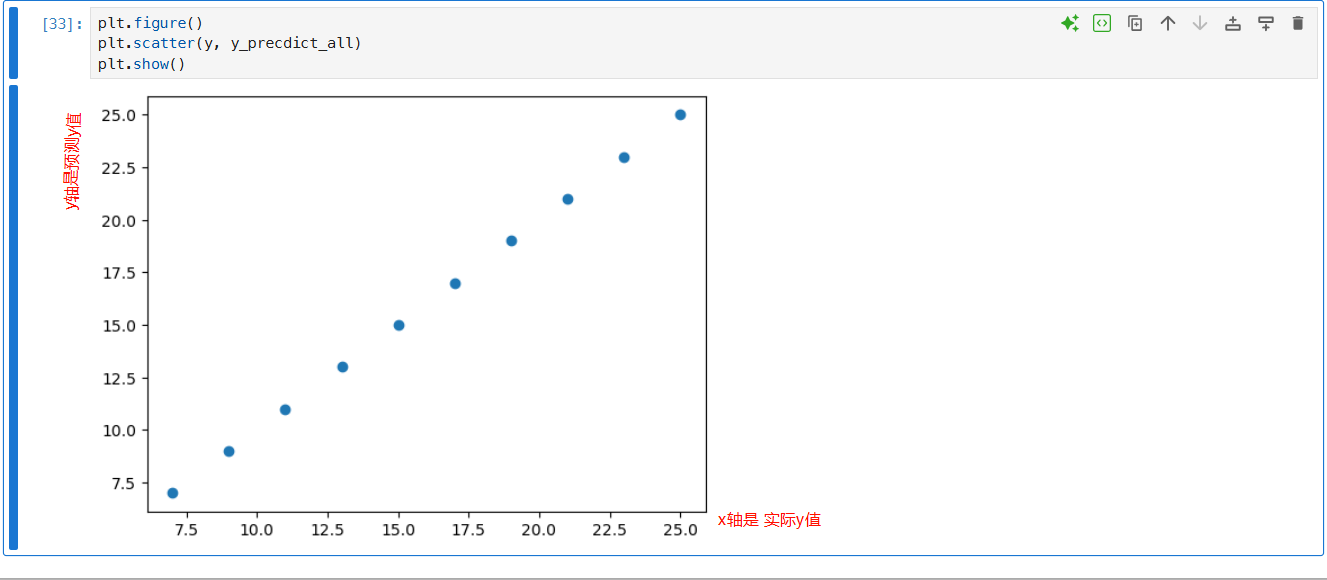
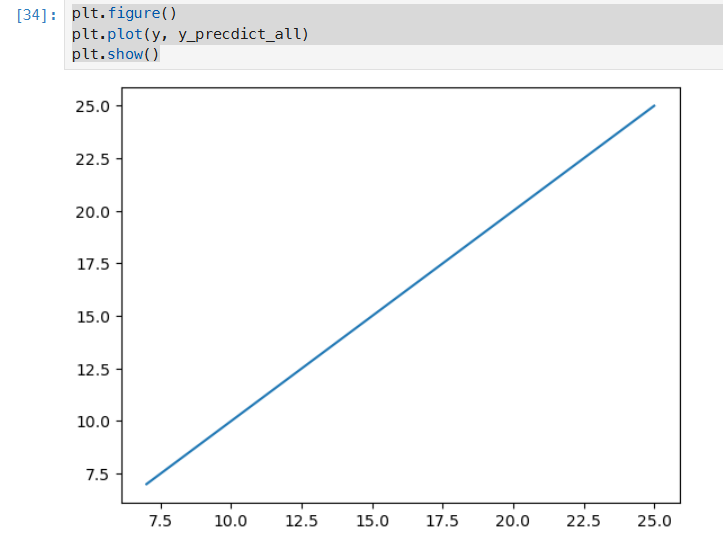
当然也可以画出一条线来:
plt.figure()
plt.plot(y, y_precdict_all)
plt.show()